Kafka vs RabbitMQ vs SQS: elige un backbone de mensajes a propósito
Backend ·
Si el trabajo es “haz esto después del HTTP”, necesitas una cola. Si el trabajo es “varios equipos consumen el mismo hecho en orden, y tal vez otra vez el mes que entra”, necesitas un log. Kafka, RabbitMQ y SQS mueven mensajes. Optimizan fallos distintos.
He usado las tres formas: colas de Redis/DB en Laravel para el día a día, SQS cuando la app ya está en AWS, RabbitMQ cuando el routing se pone interesante, y Kafka cuando varios consumidores tienen que reprocesar el mismo stream. Usar Kafka para un correo de reset de password es comprarte un cluster que vas a cuidar.
Tres modelos mentales
SQS — una cola administrada
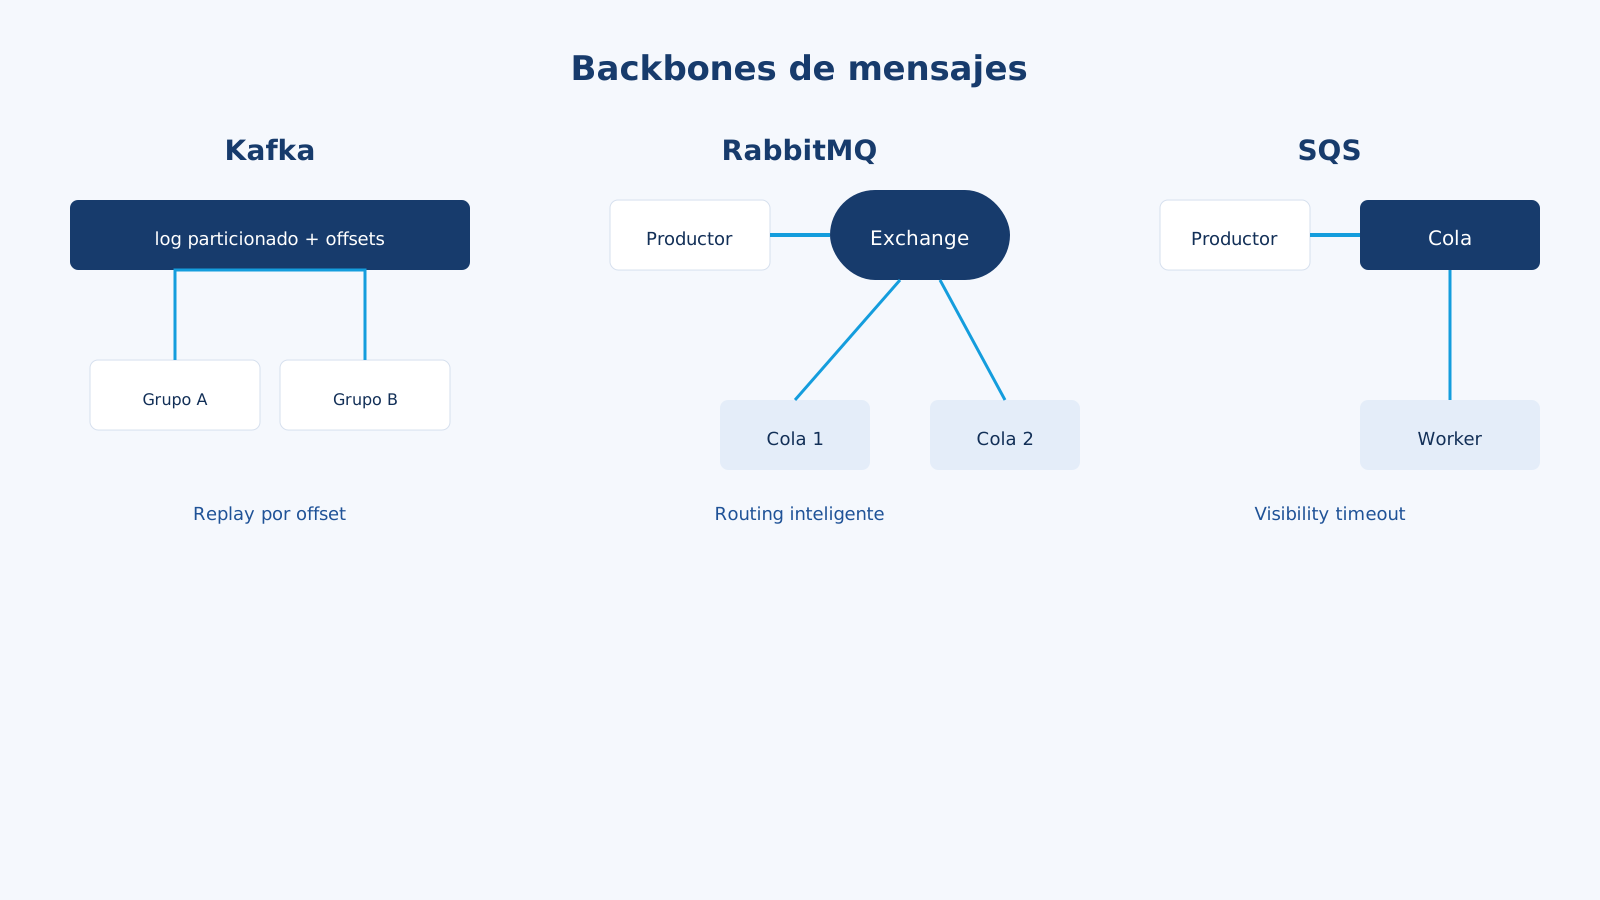
Haces SendMessage, un worker hace ReceiveMessage y luego DeleteMessage si salió bien. Mientras el worker trabaja, el mensaje está invisible (visibility timeout). Si el worker muere, el mensaje reaparece. Eso es entrega at-least-once.
No hay pub/sub en el producto core (SNS + SQS es el fan-out). Los consumidores no reprocesan historia. Una vez borrado, se acabó. Nativo de AWS, casi cero ops.
RabbitMQ — un broker con routing
Los producers publican a un exchange. El exchange rutea a queues con bindings (direct, topic, fanout). Los consumers hacen ack. Tienes dead-letter exchanges, TTL, prioridad y topología flexible.
Rabbit es bueno en routing inteligente y distribución de trabajo. No intenta guardar un mes de tráfico en disco para que un consumidor nuevo lo lea (puedes persistir, pero eso no es Kafka).
Kafka — un log distribuido
Un topic es un log particionado y ordenado. Los producers hacen append. Los consumers siguen un offset. Pueden rebobinar. Diez servicios leen orders.created a su ritmo. La retención es tiempo o tamaño, no “hasta el ack”.
Kafka es un stream durable. El costo de ops es real (o pagas MSK / Confluent). La ganancia es replay, fan-out y throughput alto.
Un ejemplo de pago + email + analytics
El usuario paga. Tienes que:
- Marcar la factura pagada (fuente de verdad: Postgres).
- Mandar el recibo.
- Avisar al CRM.
- Actualizar un warehouse / analytics.
- Tal vez reprocesar la semana pasada porque el job del warehouse estaba mal.
Escribe el pago en la misma transacción que una fila de outbox. Luego:
| Trabajo | Herramienta |
|---|---|
| Email + CRM, un worker cada uno, sin replay | SQS (o Rabbit, o la cola Redis de Laravel) |
El mismo evento a mail y crm | SNS -> dos colas SQS, o fanout de Rabbit |
| Analytics tiene que reprocesar una semana | Topic de Kafka payments.completed |
| Todo en AWS, dos ingenieros | SQS + SNS. MSK después, si el replay se vuelve real |
No pongas la actualización de la factura solo en una cola. La cola puede tardar o duplicar. El dinero vive primero en la base de datos.
Comparación
| SQS | RabbitMQ | Kafka | |
|---|---|---|---|
| Abstracción | Cola | Exchange + cola | Log append-only |
| Replay | No | No es el diseño | Sí, por offset |
| Orden | Best-effort; existen FIFO | Por cola, con matices | Por partición |
| Fan-out | SNS + SQS | Exchanges | Muchos consumer groups |
| Ops | Casi cero | Lo corres o lo hosteas | Lo más pesado (o MSK) |
| Throughput | Suficiente para la mayoría | Alto | Muy alto |
| Entrega | At-least-once | At-least-once | At-least-once |
| Dulce | Workers en AWS | Routing, tasks clásicos | Streaming, auditoría, muchos consumidores |
Pros y contras
SQS. Pros: no parcheas brokers; visibility timeout + DLQ es un modelo honesto; FIFO te da dedup y orden por grupo; barato en volumen web; se casa con Lambda. Contras: 256 KB; no hay replay; el fan-out es otro servicio; las colas standard pueden reordenar y duplicar; un visibility timeout más corto que el job es el setup clásico de un cargo doble.
RabbitMQ. Pros: routing keys (mail.receipt, mail.#); delayed messages y priority; cultura de task queue; corre en un VPS junto a Laravel. Contras: tú eres dueño del clustering y del disco; las alarmas de memoria cuando las colas se atrasan; replay para un servicio nuevo es incómodo; en AWS ya te empujan a SQS.
Kafka. Pros: replay y time travel; consumer groups independientes; throughput enorme; el log es el contrato de integración. Contras: peso operativo; el número de particiones es casi una puerta de un solo sentido; el orden es por partición, no global; overkill para “manda este email”.
La idempotencia no es opcional
Los tres van a entregar dos veces.
async function onPaymentCompleted(event) {
  const ok = await db.query(
    'INSERT INTO processed_events (id) VALUES ($1) ON CONFLICT DO NOTHING',
    [event.id]
  );
  if (!ok.rowCount) return;
  await sendReceipt(event.invoiceId);
}
Exactly-once en Kafka es un feature de pipelines específicos. No significa que tu SMTP no vaya a mandar dos correos si lo llamas dos veces.
Errores comunes
- Meter Kafka en la lámina porque se ve bien.
- Usar colas standard de SQS para “billing exactly once” sin keys de idempotencia.
- Visibility timeout más corto que el job.
- Tratar Rabbit como storage de largo plazo.
- Un topic gigante de Kafka sin schema y sin
event_type. - Consumir dentro del request HTTP. El request publica; un worker consume.
Cómo elijo
- AWS, equipo chico, emails, thumbnails, webhooks, sync de CRM: SQS. SNS cuando dos colas necesitan el mismo evento.
- On-prem o Docker, routing rico, workers: RabbitMQ.
- Varios consumidores, replay, analytics: Kafka (administrado si puedes).
- No estás seguro: empieza con la cola que ya tienes. Sube a Kafka cuando un segundo equipo diga “necesitamos los eventos del mes pasado”.
Una cola esconde trabajo detrás del request. Un log es la historia del negocio. Si no necesitas historia, no compres un log.