De un VPS a AWS de verdad: Route 53, CloudFront, API Gateway y cómputo
AWS ·
La mayoría de sitios que saco empiezan en una VM: Nginx, la app, MySQL, a veces Redis. Este CV es de esa familia — Astro se buildea en GitHub Actions y una caja en DigitalOcean sirve archivos estáticos. Es arquitectura honesta. También no es lo mismo que “estamos en AWS”.
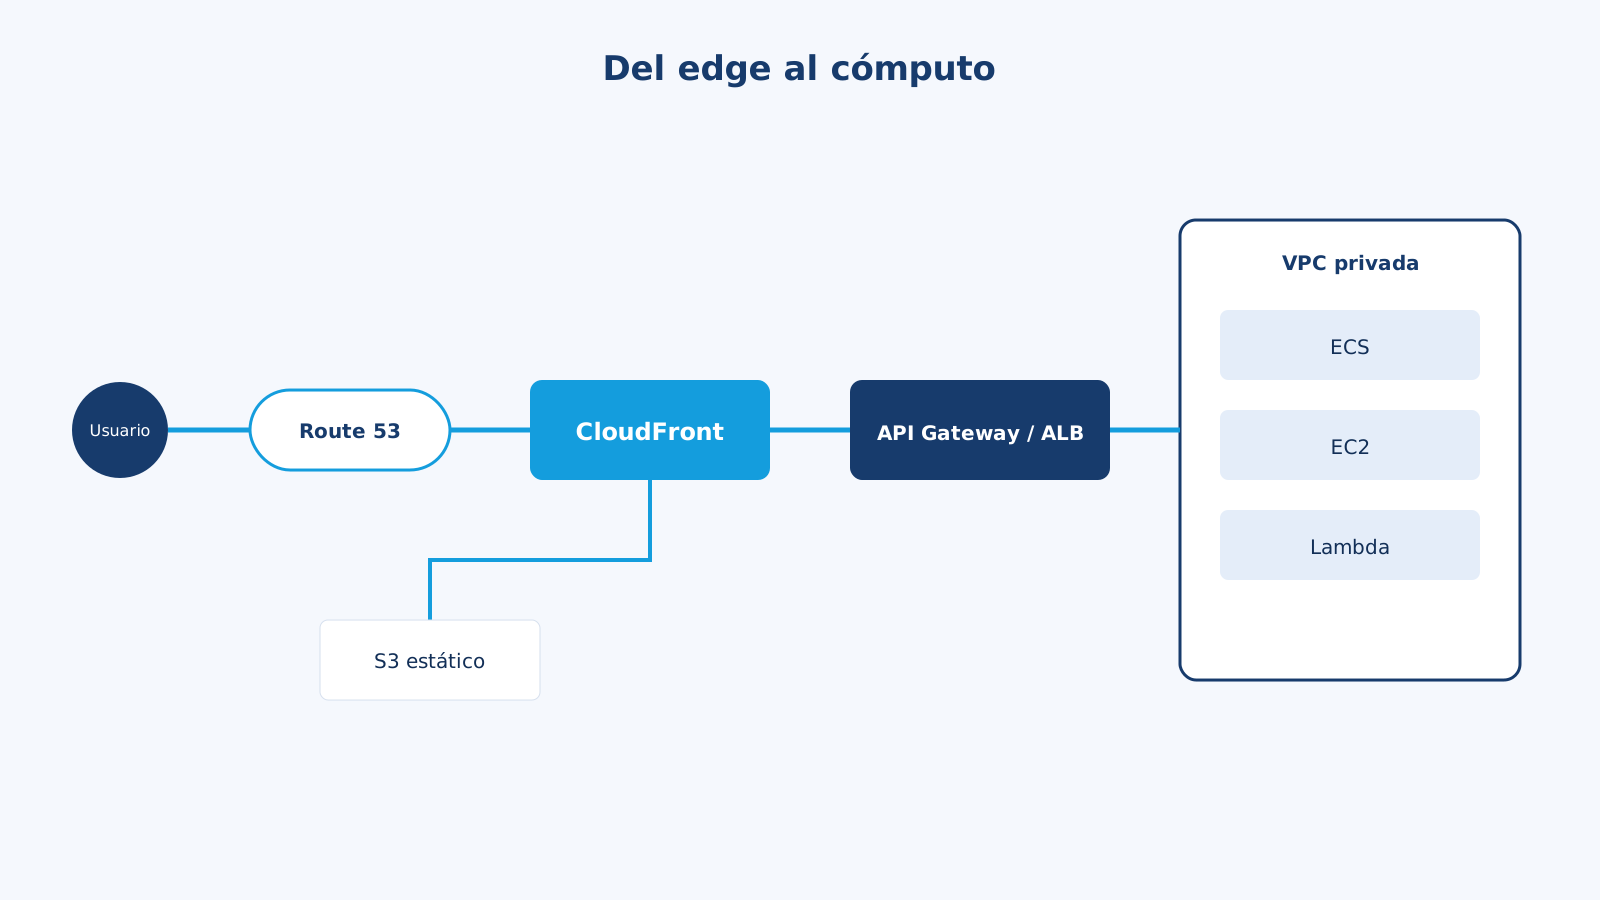
AWS vale la ceremonia cuando necesitas aislar el radio de explosión, un CDN, TLS administrado, escala independiente para estáticos vs API vs jobs, y una historia para el fallo. El diagrama que la gente dibuja es:
Usuario -> Route 53 -> CloudFront (CDN)
                         |-- S3        (estáticos / este blog)
                         |-- API Gateway o ALB
                                 |-- Lambda
                                 |-- ECS (Fargate)
                                 |-- EC2
                                 '-- SQS -> workers
Voy a caminar ese path hop por hop, compararlo con “hosting normal”, y marcar los hops que me salto hasta que aparece un requisito de verdad.
Hosting normal (el VPS)
Usuario -> DNS (A record) -> 203.0.113.10
                               Nginx (TLS)
                                 |-- estáticos
                                 '-- PHP-FPM / Node
                                       '-- MySQL en el mismo disco
Pros: puedes entrar por SSH y ver la cosa. El debug es tail -f. El precio es un droplet plano. Perfecto para un CV, un brochure, un CRM chico, un SaaS temprano.
Contras: TLS, updates, disco, backups y fail2ban son tuyos. Escalar es “caja más grande”. Un disco muere y se mueren sitio y base juntos. Un deploy que llena el disco se lleva el blog y la API. Usuarios en otro continente pegan a tu única región siempre.
No hay nada vergonzoso aquí. Sigo hosteando así hasta que una restricción fuerza el siguiente hop.
Un path AWS más completo
1. Route 53 — DNS que puede pensar
Route 53 es DNS más health checks y traffic policies.
- Alias
A/AAAAa CloudFront api.example.comalias a un ALB o a API Gateway- Failover entre regiones si de verdad tienes una segunda
- Weighted records para un corte lento
En un VPS casi siempre tienes un A record en el registrador. Funciona hasta que quieres cambios de IP sin downtime.
2. CloudFront — el CDN / reverse proxy de edge
Este hop cambia la experiencia del usuario.
- HTML/JS/CSS de Astro desde S3 en el edge
- TLS en el edge con ACM
- WAF frente a la distribution
- Cache de
GETpúblicos; nunca cachees HTML conSet-Cookiepor accidente - Failover de origin
/           -> S3 (estático)
/assets/*   -> S3 (caché larga)
/api/*      -> ALB o API Gateway (caché apagada o muy corta)
Si todo el producto es una API usada por una sola oficina, CloudFront puede esperar. Si tienes un sitio público o una app con imágenes, ponlo desde el día uno.
3. Puerta de la API: API Gateway o ALB
Escribí la comparación completa en API Gateway vs load balancer. La versión corta:
| Tienes | Puerta |
|---|---|
| Laravel o Node en ECS/EC2, clientes de primer partido | ALB |
| Lambdas, API keys de partners, usage plans | API Gateway |
| Mix | Routing de CloudFront, o Gateway frente a ALB solo si necesitas features de Gateway |
No hagas Gateway -> ALB -> un contenedor “porque el diagrama traía los dos”.
4. Cómputo: Lambda vs ECS vs EC2
Elijo por la forma del proceso.
Lambda: código que arranca, atiende un evento y se sale. Webhooks, resize, PDF, cron, APIs con tráfico de ráfaga. Pagas por invocación. Escala a cero. Timeouts, package size y cold starts. Un boot gordo de Laravel puede sentirse mal.
ECS en Fargate: un contenedor que se queda arriba: Laravel Octane, un worker, un proceso de WebSocket. No parcheas EC2. Sigues diseñando CPU/memoria, autoscaling y health checks. Mi default para “esto es una app de verdad” en AWS cuando no quiero SSH a AMIs.
EC2: cuando necesitas un módulo de kernel, un GPU, una licencia o estás levantando una VM mascota. O cuando el costo en load enorme y estable le gana a Fargate. Vuelves a parchear.
API HTTP, ráfagas, poco estado     -> Lambda
API HTTP, always-on, WebSockets    -> ECS
Workers de fondo                   -> servicio ECS o Lambda en SQS
PHP legacy en AMI custom           -> EC2 (y planea la salida)
Un bot de WhatsApp + inbox de admin lo partiría: API en ECS, el receiver del webhook puede ser Lambda (verifica, tira a SQS), workers en ECS o Lambda, admin estático en S3 + CloudFront.
5. El resto de la VPC privada
Un dibujo “full AWS” que se detiene en Lambda es mentira. Producción también tiene:
- VPC con subnets públicas (ALB, NAT) y privadas (ECS, RDS)
- RDS Multi-AZ cuando la tabla de facturas importa
- ElastiCache Redis para sesiones y colas (ver sesiones vs JWT)
- SQS para async (ver Kafka vs RabbitMQ vs SQS)
- ECR para imágenes, GitHub Actions para el build, OIDC hacia IAM en lugar de keys largas de AWS
- Secrets Manager o SSM — no un
.enven una AMI pública - CloudWatch + alarms. Si nadie pagina, no tienes producción, tienes esperanza
Lado a lado
| Tema | VPS / hosting normal | Path AWS más completo |
|---|---|---|
| DNS | A record del registrador | Alias de Route 53 + health |
| TLS | Certbot en la caja | ACM en CloudFront / ALB |
| Estáticos | Nginx desde disco | S3 + CloudFront |
| App | La misma caja que Nginx | ECS/EC2/Lambda en subnets privadas |
| Escala | Vertical | Horizontal por servicio |
| Deploy | git pull && ./deploy.sh | Imagen, roll de task def / versión de Lambda |
| Fallo | Caja abajo = todo abajo | AZ, health de targets, DLQ |
| Costo | Simple | Muchas cuentas chicas; el NAT idle es un clásico |
| Equipo que lo disfruta | 1–3 | 2+ que van a dueñarse de IAM y networking |
Pros y contras de brincar a AWS completo
Pros: estáticos y API escalan aparte. Un spike del blog no se sienta en el mismo PHP-FPM que el checkout. Puedes bajar un servicio de ECS a cero tasks en la noche. IAM es un boundary real si lo usas. Multi-AZ RDS es un checkbox que no vas a implementar tú con un disco USB.
Contras: un hello-world ahora incluye VPC, subnets, NAT ($32/mes antes de tráfico), ALB ($16+) y un log group. El debug es CloudWatch, no vim. IAM te va a bloquear un día y ese día sigue siendo más barato que un bucket S3 abierto. Puedes recrear un VPS peor: un EC2, IP pública, todos los puertos, MySQL en la instancia. Eso no es “AWS completo”. Eso es un droplet con pasos extra.
Un deploy que sí correría
Hoy (cabe en este repo)
GitHub -> Actions -> astro build -> rsync/ssh al VPS -> Nginx
Siguiente paso si la API crece (no porque AWS se vea más cool)
GitHub -> Actions
            |-- astro build -> S3 -> invalidación de CloudFront
            '-- docker build -> ECR -> deploy de ECS
Route 53
   blog.example.com  -> CloudFront -> S3
   api.example.com   -> ALB -> ECS (Laravel)
                              -> SQS -> worker ECS
                         RDS + Redis en subnets privadas
No pondría el formulario de contacto de un CV detrás de API Gateway + cuatro Lambdas + Step Functions. Un contact form serverless es un buen tutorial. No es automáticamente mejor que un form HTML y un correo.
Errores comunes
- RDS público. Si el security group permite
0.0.0.0/0:3306, el resto del diagrama es teatro. - CloudFront frente a un admin POST dinámico con el cache behavior default.
- Un task gigante de ECS: nginx + php + queue + cron + mysql sidecar. Reconstruiste el VPS.
- Lambda para un reporte de 90 segundos y luego sorpresa de timeout. Usa ECS o un job + 202.
- Guardar uploads en el filesystem del contenedor. Usa S3.
- Saltar WAF y confiar en “seguridad por URL escondida”.
Cómo elijo
- CV, brochure, blog de pocas escrituras: host estático o un VPS. Este sitio puede quedarse aquí mucho tiempo.
- Estáticos globales + una API: CloudFront + S3 + ALB/ECS. Route 53 en cuanto te cansen los A records.
- Webhooks de ráfaga y poco idle: API Gateway + Lambda + SQS.
- Sockets always-on o una app PHP gorda: ECS, no Lambda.
- No podemos caernos con un disco: RDS Multi-AZ y al menos dos tasks en dos AZs. Eso — no la ensalada de logos — es el upgrade.
El movimiento maduro no es agregar cada servicio de AWS. Es nombrar el hop que quita un riesgo que de verdad tienes. DNS, edge, puerta, cómputo, datos. Dibuja esos cinco. Borra las cajas que no se ganan una oración. Esa es la arquitectura que quiero en un currículum y en producción.